大模型训练为什么容易失败:数据、显存、通信与恢复机制
大模型训练失败往往代价很高。一次任务可能占用多机多卡运行数小时甚至数天,失败后如果无法恢复,就会浪费大量算力和研发时间。很多失败表面上看是框架报错,实际根因可能在数据、显存、通信、节点或平台策略。
本文从训练链路拆解大模型训练为什么容易失败,以及平台应该如何减少失败影响。它的重点不是某个错误码,而是让团队知道该从哪些系统维度建立稳定性机制。


相关主题可以结合 模型训练、GPU调度、AI基础设施 一起阅读。本文更关注平台治理和工程判断,不把问题简化成单个工具选择。
数据链路问题会在训练中被放大
训练任务依赖持续稳定的数据读取。数据路径错误、样本损坏、权限变化、存储抖动、预处理瓶颈都会影响训练。小规模实验中不明显的问题,在多机训练中会被并发读取放大。
如果数据读取跟不上,GPU 会等待,表现为利用率波动。团队可能误以为是调度问题或 GPU 问题,但真正瓶颈在数据链路。
平台应记录数据读取吞吐、失败样本、缓存命中率和存储延迟。对关键数据集,还应在训练前做可访问性和完整性检查。
显存不足不只是模型太大
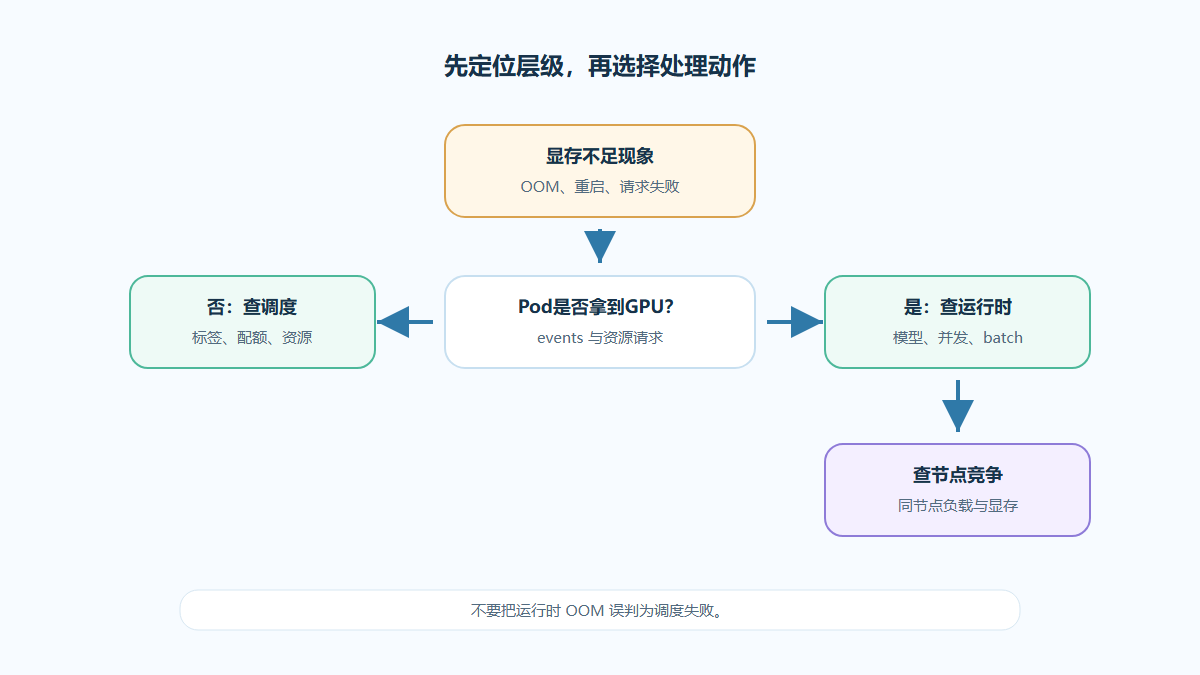
显存不足可能来自模型参数、优化器状态、激活值、批大小、序列长度和临时缓存。不同训练策略对显存的影响不同,不能只按模型大小估算。
很多任务在启动初期看似正常,但运行到某个阶段才 OOM,原因可能是动态输入长度、评估阶段、Checkpoint 保存或特定 batch 触发了更高显存占用。
平台可以提供显存画像和规格建议,帮助用户在提交任务前选择合适 GPU、批大小和并行策略。对于反复 OOM 的任务,应沉淀成可诊断的失败类型。

通信问题决定多机训练效率
多机多卡训练依赖频繁通信。网络抖动、跨机拓扑不合理、通信库版本不一致、节点性能差异都会拖慢整体训练。一个慢节点可能让所有 Worker 等待。
通信问题的难点在于它不一定导致任务立即失败,而是让训练效率大幅下降。平台如果只看任务状态,会认为任务正常运行;只有观察 step time、通信等待和节点差异,才能发现问题。
调度层面应尽量让强通信任务落在网络质量更好的节点组合上,并避免把关键训练任务分散到不合适的拓扑中。
节点和环境不一致会造成隐性失败
训练环境包括镜像、驱动、CUDA、通信库、Python 依赖和数据挂载方式。只要不同节点环境不一致,多机任务就可能出现难以复现的失败。
平台应尽量通过镜像和节点准入机制保证环境一致。对于 GPU 节点,还要关注驱动版本、设备健康状态和历史故障。
当训练失败发生时,日志应能关联到具体节点、镜像版本和资源池。否则排查只能依赖人工猜测。

Checkpoint 是降低失败成本的关键
大模型训练无法避免所有失败,因此平台必须降低失败后的损失。Checkpoint 机制能让任务从中间状态恢复,而不是从头开始。
Checkpoint 策略需要考虑保存频率、保存位置、写入耗时、保留版本和恢复验证。保存太频繁会影响训练性能,保存太少又会增加失败损失。
平台应把 Checkpoint 与抢占、重试和迁移策略结合。只有任务能可靠恢复,抢占和弹性调度才不会变成高风险操作。
平台化治理比单次排错更重要
训练失败排查不能停留在某次任务日志。平台应统计失败类型、资源池、节点、镜像、数据集和任务规格之间的关系,识别重复问题。
例如某个节点频繁导致训练失败,应自动降权或隔离;某类任务反复 OOM,应提示规格建议;某个数据集访问失败率高,应进入数据治理流程。
当失败经验沉淀为平台规则,训练团队才能减少重复踩坑,把精力放在模型本身。
常见问题
大模型训练失败最常见的原因是什么?
常见原因包括显存不足、数据读取异常、通信阻塞、节点故障和环境不一致。实际排查时需要结合日志、指标和资源状态。
Checkpoint 保存越频繁越好吗?
不是。保存频率越高,恢复损失越小,但也会增加存储和写入开销。需要按任务时长和失败风险设置。
平台能完全避免训练失败吗?
不能。平台更现实的目标是提前发现风险、减少失败概率,并通过恢复机制降低失败成本。
小结
大模型训练失败治理的关键,不是把所有能力一次性做完,而是先识别真正影响效率和稳定性的环节,再把规则、指标和流程沉淀到平台中。对于已经有一定云原生基础的团队来说,持续补齐这些深度治理能力,往往比继续堆叠概念更有价值。